Dual-Engine AI Agent: Bài học từ System 1 và System 2
Kiến trúc Dual-Engine AI Agent qua mã nguồn thực tế: phân vai System 1, System 2, kiểm thử shadow mode, đo chi phí đúng và bảo vệ key, token trước khi xuất bản.
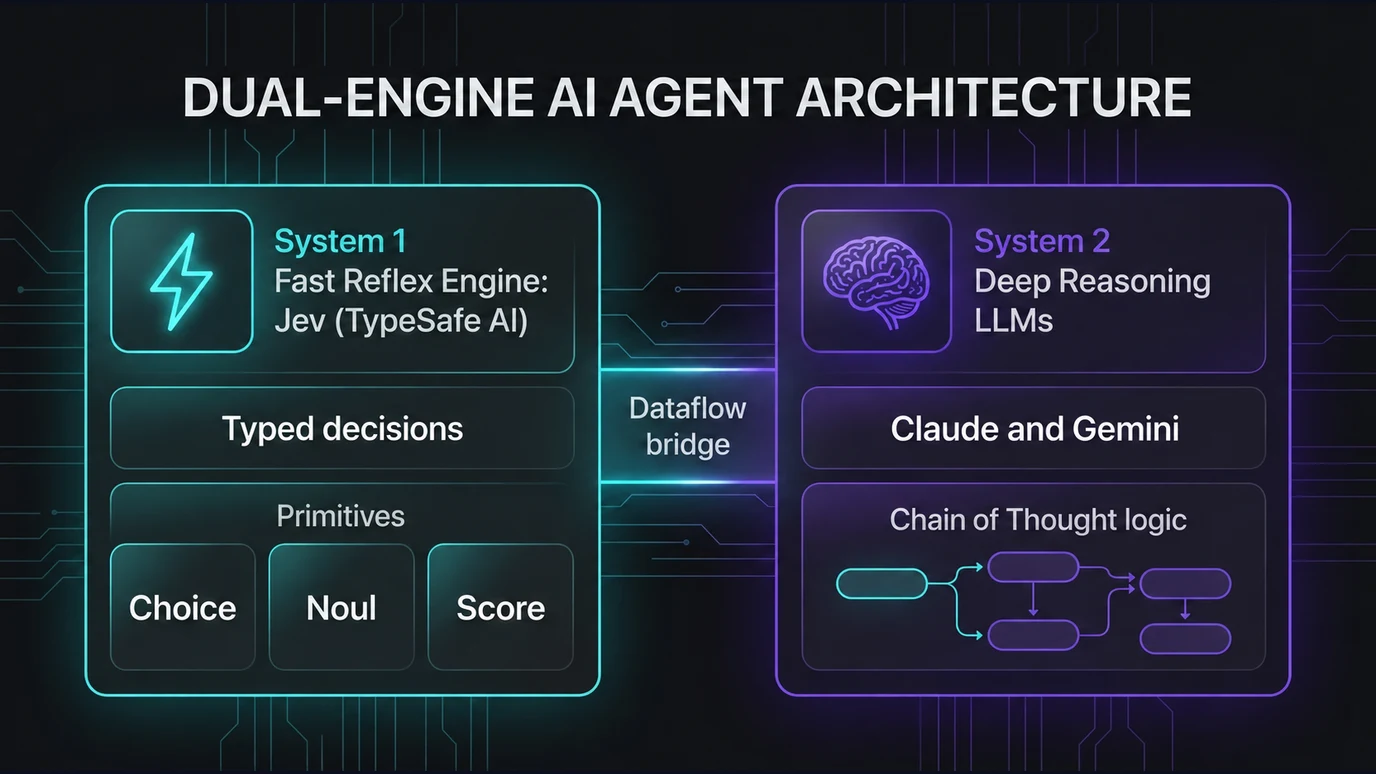
TL;DR: Dual-Engine tách phân loại ngắn ở System 1 khỏi lập kế hoạch và tạo nội dung ở System 2. Khi đối chiếu mã nguồn hệ thống của Tùng, bài học chính nằm ở cách kiểm soát bàn giao: phân biệt shadow mode với quyền thực thi, ghi nhận fallback, đo cả workflow và giữ xác thực độc lập với phán đoán AI.
Một yêu cầu “viết bài” và một yêu cầu “gửi lại bản nháp” có thể cùng chứa từ khóa nội dung. Nếu router hiểu sai, hệ thống tạo thêm bài thay vì trả đúng tài liệu. Đổi sang model mạnh hơn chưa chắc giải quyết được vấn đề. Cần xác định quyết định nào được giao cho AI, bằng chứng nào đủ để chuyển bước và ai được phép thực thi.
Đây là cách Tùng nhìn kiến trúc Dual-Engine qua dự án đang xây dựng. Bản cập nhật ngày 23/09/2026 đối chiếu mã nguồn CRM và gateway Telegram trong hệ sinh thái AI Agent. Có lời gọi trong mã nguồn không đồng nghĩa đã xác minh triển khai production hoặc đo được hiệu quả trên traffic thật. Bài viết giữ ranh giới đó để người đọc biết phần nào đã có, phần nào còn cần kiểm thử.
Dual-Engine System 1 và System 2 là gì?
Dual-Engine là cách phân chia trách nhiệm giữa tầng quyết định ngắn và tầng xử lý cần nhiều ngữ cảnh. System 1 chọn nhãn, nhận diện ý định hoặc đánh giá một điều kiện hẹp. System 2 lập kế hoạch, tổng hợp tài liệu và tạo đầu ra dài. Tên gọi này là phép liên hệ về thiết kế, không phải mô tả hai vùng não vật lý của một mô hình.
Theo tài liệu TypeSafe, Jev nhận trạng thái cùng câu hỏi có kiểu dữ liệu. Choice chọn một phương án, Noul đánh giá một mệnh đề, còn Score chấm theo rubric. Đây là những công cụ phù hợp với quyết định có phạm vi rõ. Đầu ra đúng kiểu vẫn có thể sai ý nghĩa; ứng dụng cần kiểm tra giá trị và quyết định cách sử dụng.
Với Tùng, góc nhìn này nối tiếp Director Mindset: thiết kế trách nhiệm của từng bước trước khi chọn công cụ. Các quy tắc chắc chắn như kiểm tra quyền truy cập, giới hạn dung lượng và đối chiếu trạng thái đơn hàng nên nằm trong code. Không cần gọi AI để giải một điều kiện đã biết chính xác.
Mã nguồn thực tế đã áp dụng đến đâu?
Bản rà soát cho thấy tích hợp đã vượt qua mức module đứng riêng. Tuy nhiên, mỗi nơi sử dụng kết quả theo một cách khác nhau.
| Thành phần được đối chiếu | Điều xác nhận được từ mã nguồn | Giới hạn của bằng chứng |
|---|---|---|
| Router trong CRM | Có phân loại nội dung, phòng ban, agent và nhánh heuristic dự phòng | Chưa đủ để kết luận mọi request đều dùng Jev |
| Dispatcher của CRM | Gọi router ở shadow mode, đính kèm kết quả để đối chiếu | Kết quả Jev chưa thay quyết định phân phòng ban hiện có |
| Webhook tiếp nhận yêu cầu | Có lời gọi kiểm tra đầu vào và định tuyến | Cần kiểm thử triển khai, xác thực và quyền trước khi coi là an toàn |
| Gateway Telegram | Có lời gọi định tuyến cho tác vụ văn bản và media | Chưa có benchmark production được xác minh trong lần rà soát này |
Sự khác nhau này quan trọng hơn một nhãn “đã tích hợp”. Shadow mode cho phép quan sát kết quả của engine mới mà chưa trao quyền thay đổi quyết định nghiệp vụ. Ngược lại, một nhánh đã dùng kết quả để chọn agent cần được kiểm tra kỹ hơn vì sai phân loại có thể ảnh hưởng bước sau.
Một chi tiết đáng chú ý: lời gọi shadow mode trong dispatcher được await trước khi trả kết quả. Nó chưa đổi quyết định nhưng vẫn có thể tăng thời gian chờ. Vì vậy, “chạy đối chiếu” không tự động có nghĩa là “không tác động hiệu năng”. Đây là bài học có thể kiểm chứng trực tiếp từ luồng xử lý, không cần suy diễn một tỷ lệ tiết kiệm.
Những bài học từ router và fallback
Timeout là giới hạn chờ được cấu hình, không phải tốc độ đo được. Module CRM đặt thời gian chờ 2.000 ms cho định tuyến và 1.500 ms cho kiểm tra đầu vào. Khi hai bước chạy tuần tự, thời gian chờ có thể cộng dồn, rồi còn bước tạo nội dung và ghi nhận kết quả. Không thể lấy một thông số của model làm độ trễ toàn workflow.
Fallback duy trì một đường xử lý, nhưng chất lượng có thể khác. Khi thiếu cấu hình hoặc lời gọi thất bại, router chuyển về heuristic. Đầu ra có trường engine giúp phân biệt hai đường. Nếu chỉ đếm response thành công, người vận hành có thể tưởng Jev đang xử lý tốt trong khi phần lớn request đi qua dự phòng.
Điểm số gán trong code không phải xác suất đã đo. Một số nhánh heuristic trả về mức confidence cố định; nhánh nhận câu trả lời cũng có giá trị mặc định khi thiếu trường. Những giá trị ấy không nên xuất hiện trong báo cáo như độ chính xác thực nghiệm. Cần tách điểm từ model, mặc định của ứng dụng và kết quả đối chiếu với nhãn do người kiểm duyệt xác nhận.
Ưu tiên định tuyến cần có ca kiểm thử riêng. Bộ kiểm thử nên chứa yêu cầu tạo bài, xin lại link, hỏi trạng thái và câu chứa nhiều ý định. Với “gửi lại bản nháp video”, nhánh tra cứu cần được đánh giá độc lập thay vì chỉ bắt từ “video”. Đây là tình huống kiểm thử đề xuất, không phải tuyên bố đã đo thành công trên khách hàng thật.
Thiết kế ranh giới bàn giao như thế nào?
Ranh giới tốt đặt kiểm soát quyền trước khi gọi model và kiểm tra hành động trước khi thực thi. Luồng dưới đây là thiết kế khuyến nghị, không phải bản sao đầy đủ của tất cả endpoint hiện tại.
Tiếp nhận yêu cầu
  → Xác thực nguồn gửi và xác định phạm vi dữ liệu
  → Áp dụng quy tắc chắc chắn, loại dữ liệu không cần thiết
  → System 1 phân loại câu hỏi hẹp
  → Kiểm tra đầu ra, độ tin cậy và chính sách rủi ro
  → System 2 xử lý phần cần tổng hợp hoặc lập kế hoạch
  → Kiểm duyệt đầu ra và xin duyệt hành động quan trọng
  → Thực thi trong quyền đã được cấp
| Tình huống | Quyết định thiết kế |
|---|---|
| Điều kiện xác định được bằng code | Xử lý trực tiếp, tránh thêm lời gọi model |
| Phân loại hẹp, rủi ro thấp | Cân nhắc System 1 sau khi so với baseline |
| Ý định mơ hồ hoặc thiếu dữ kiện | Hỏi làm rõ hoặc chuyển bước phân tích |
| Thiếu kết quả kiểm tra an ninh | Chặn hoặc đưa sang hàng chờ duyệt theo chính sách |
| Xuất bản, thanh toán, thay đổi quyền | Bắt buộc kiểm tra quyền và cổng duyệt riêng |
Fallback của một bộ phân loại nội dung có thể là heuristic. Fallback của một chốt bảo mật không nên mặc nhiên là “cho phép”. Qua rà soát, các module được đọc vẫn có nhánh xem đầu vào là an toàn khi regex không khớp và có mặc định rủi ro thấp khi thiếu câu trả lời. Đây là giới hạn cần cải thiện, không phải bằng chứng hệ thống đã có cơ chế chặn khi lỗi hoàn chỉnh.
Bảo mật: không đưa key và token vào bài viết
Classifier phát hiện prompt injection chỉ là một lớp hỗ trợ. Nó không chứng minh người gửi đã đăng nhập, không xác định quyền truy cập tài liệu và không thay thế việc cô lập dữ liệu giữa các tài khoản. Nhãn “an toàn” từ AI cũng không cấp quyền gọi công cụ.
Nội dung công khai phải dùng ví dụ tổng hợp, không sao chép nguyên log hoặc ảnh chụp cấu hình. Key, token truy cập, cookie phiên, chữ ký truy cập và đường dẫn có tham số xác thực đều phải được loại bỏ. Tên biến cấu hình có thể hữu ích trong tài liệu kỹ thuật, nhưng giá trị xác thực không có lý do xuất hiện trong bài này.
Việc kiểm tra cần bao phủ cả bản Việt và Anh, metadata, code block, URL liên kết, HTML xuất ra và dữ liệu có cấu trúc. Dịch bài không phải là bước khử bí mật: một chuỗi nhạy cảm có thể được giữ nguyên ở bản dịch. Ảnh chụp và tài liệu đính kèm cũng cần xem riêng vì quét văn bản không đọc được mọi thông tin trong ảnh.
Trong vận hành, chỉ chuyển ngữ cảnh cần thiết sang dịch vụ phân loại. Dữ liệu khách hàng và nội dung chưa công bố cần tuân theo chính sách chia sẻ dữ liệu. Log nên giữ mã yêu cầu nội bộ, nhãn quyết định, thời gian xử lý và loại lỗi; tránh ghi toàn bộ payload hoặc đối tượng lỗi chưa được lọc.
Đo chi phí và độ trễ sao cho đúng?
Đơn giá token không phải chi phí mỗi quyết định. TypeSafe công bố mức 42 USD cho một tỷ input token tại thời điểm đối chiếu, tương đương 0,042 USD cho một triệu input token. Đây là đơn giá nhà cung cấp, không phải hóa đơn thực tế của dự án và có thể thay đổi.
Ví dụ tính toán giả định: nếu phần đầu vào được tính phí là 1.000 token, chi phí phần đó theo đơn giá trên là 0,000042 USD. Con số 0,000000042 USD tương ứng một input token, không phải một request bất kỳ. Cần kiểm tra cách tính phí hiện hành và cộng retry, fallback, System 2, hạ tầng cùng công kiểm duyệt để có chi phí hoàn thành công việc.
Bảng đo hữu ích cần bao gồm độ trễ đầu cuối p50/p95, tỷ lệ gọi lỗi, tỷ lệ fallback, tỷ lệ phân loại sai và chi phí trên tác vụ được chấp nhận. So sánh các phương án trên cùng bộ yêu cầu có nhãn, cùng điều kiện đo. Một lần gọi sandbox không xác lập độ ổn định hay hiệu quả production.
Bản cập nhật này không sử dụng lại thời gian phản hồi, tỷ lệ tiết kiệm hoặc số đo sandbox cũ như kết quả đã tái xác minh. Chưa có bộ dữ liệu đo phù hợp thì nên công bố cách đo và trạng thái tích hợp. Thêm nhiều chốt AI chỉ vì đơn giá thấp vẫn có thể làm tổng chi phí và độ trễ tăng lên.
Khi nào nên áp dụng cho dự án của bạn?
Bắt đầu bằng một quyết định lặp lại, dễ gán nhãn và ít rủi ro. Ghi lại baseline hiện tại, chạy engine mới ở shadow mode, phân tích các trường hợp bất đồng rồi mới cân nhắc mở quyền. Đặt tiêu chí chấp nhận trước khi xem kết quả để tránh chỉ chọn những ví dụ đẹp.
Với tác vụ ảnh hưởng dữ liệu hoặc danh tiếng, giữ chốt chặn kiểm duyệt của con người ở đúng hành động. Một kết quả phân loại tốt không đồng nghĩa bản nháp đã được duyệt đăng. Bài học quan trọng nhất từ lần đối chiếu này là quản lý ranh giới trách nhiệm: biết engine nào thực sự đã chạy, đầu ra nào được tin và quyền nào vẫn thuộc về con người.
Câu hỏi thường gặp (FAQ)
System 1 có thay thế System 2 không?
Không. System 1 phù hợp với quyết định hẹp; System 2 xử lý tổng hợp và lập kế hoạch. Quy tắc chắc chắn vẫn nên nằm trong code, còn hành động quan trọng cần cơ chế phân quyền độc lập.
Đã có module Jev thì coi như triển khai xong chưa?
Chưa. Cần xác nhận nơi gọi, chế độ shadow hay thực thi, đường fallback và kết quả kiểm thử. Mã nguồn có tích hợp chưa chứng minh phiên bản đó đang phục vụ production hoặc đáp ứng mục tiêu hiệu năng.
Đầu ra có kiểu dữ liệu có bảo đảm an toàn không?
Không. Đúng cấu trúc không bảo đảm đúng ý định hay đúng quyền. Ứng dụng vẫn cần xác thực, kiểm tra phạm vi dữ liệu, kiểm tra giá trị đầu ra và xử lý trường hợp thiếu kết quả.
Có thể dùng log thật làm ví dụ trong bài không?
Chỉ khi đã làm sạch và kiểm tra quyền công bố. Bài này ưu tiên ví dụ tổng hợp, không đưa giá trị key, token, cookie, chữ ký hay thông tin định danh khách hàng vào nội dung ở bất kỳ ngôn ngữ nào.
Nhận Bộ Thư Viện Prompt & SOP AI Workflow Vận Hành Doanh Nghiệp 2026
Tặng miễn phí Ebook PDF + Notion Template quản lý AI System thực chiến từ Tôi Là Tùng. Gửi trực tiếp vào hòm thư công việc của bạn.
Khám Phá Kho Workflow & SOP AI Thực Chiến
Thư viện quy trình n8n, Make.com và SOP vận hành AI tôi đang dùng thật — chọn đúng thứ bạn cần cho hệ thống của mình.

Bài Liên Quan
Hạ Tầng AI Architecture 2026: 4 Trụ Cột Scale Hệ Thống Tinh Gọn
Tháng thứ tư với hệ thống AI Agent: khi sự hào hứng biến mất và kỷ luật bắt đầu