System 1 trong AI Agent là gì? Tầng phản xạ giá rẻ cho agent
System 1 là tầng phản xạ nhanh, chi phí thấp của AI Agent: phân loại intent, định tuyến và gác cổng trước khi gọi model lớn. Kèm bảng giá token niêm yết.
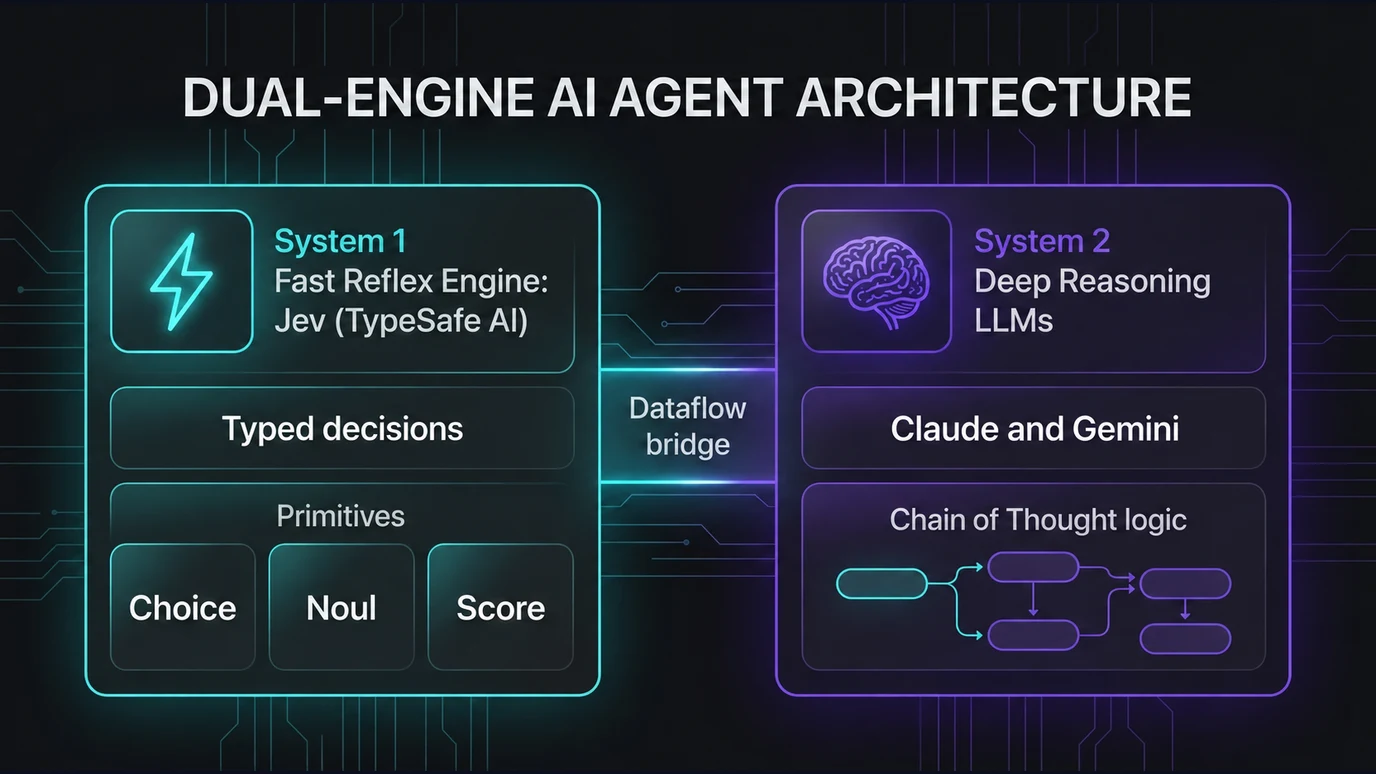
TL;DR: System 1 trong AI Agent là tầng phản xạ nhanh, chi phí thấp. Tầng này dùng model nhỏ để phân loại intent, định tuyến, trích xuất dữ liệu thô và gác cổng cú pháp, rồi chỉ chuyển sang System 2 (model suy luận lớn) khi gặp logic phức tạp. Phần chi phí trong bài là kịch bản tính toán giả định dựa trên bảng giá niêm yết, không phải số đo từ hệ thống đang chạy.
Khi một agent nhận mọi yêu cầu, từ việc phân loại một tin nhắn đến việc lập kế hoạch nhiều bước, và gửi tất cả vào cùng một model lớn, hóa đơn token tăng theo số lượng yêu cầu chứ không theo độ khó của chúng. Phần lớn yêu cầu trong vận hành thực tế là việc ngắn và lặp lại. Bài này giải thích System 1 là gì, nằm ở đâu trong kiến trúc, và cách ước tính chi phí một cách trung thực, tức là chỉ từ giá niêm yết và các giả định được ghi rõ.
System 1 trong AI Agent là gì?
System 1 là tầng phản xạ của agent: một model nhỏ, nhanh, giá thấp, xử lý các quyết định ngắn và có phạm vi hẹp trước khi bất kỳ model lớn nào được gọi. System 2 là tầng suy luận chậm hơn, tốn kém hơn, chỉ được kích hoạt khi System 1 xác định yêu cầu cần lập kế hoạch hoặc tổng hợp phức tạp.
Các việc điển hình của System 1:
- Phân loại intent: yêu cầu này là hỏi thông tin, đặt lịch, khiếu nại hay tạo nội dung.
- Định tuyến prompt: chọn đúng agent hoặc công cụ cho yêu cầu.
- Trích xuất dữ liệu thô: lấy tên, số điện thoại, mã đơn từ văn bản tự do.
- Gác cổng cú pháp: kiểm tra đầu vào có đúng định dạng, có dấu hiệu prompt injection hay không, trước khi đi tiếp.
Vì sao mượn mô hình tâm lý học của Kahneman?
Vì cách chia nhanh và chậm của Daniel Kahneman mô tả khá sát cách nên chia trách nhiệm cho các tầng model. Trong cuốn Thinking, Fast and Slow (2011), Kahneman gọi System 1 là kiểu suy nghĩ nhanh, tự động, ít tốn công, và System 2 là kiểu suy nghĩ chậm, có chủ ý, tốn nhiều công sức.
Đây là phép liên hệ về thiết kế, không phải khẳng định rằng model ngôn ngữ vận hành giống bộ não con người. Giá trị của phép liên hệ nằm ở chỗ nó buộc người thiết kế trả lời một câu hỏi thực dụng: quyết định nào đủ đơn giản để xử lý bằng phản xạ rẻ, và quyết định nào thật sự cần suy luận. Bài Dual-Engine AI Agent: bài học từ System 1 và System 2 đối chiếu cách chia này với mã nguồn của một hệ thống cụ thể và chỉ ra những giới hạn của nó.
System 1 và System 2 khác nhau ở đâu?
System 1 tối ưu cho tốc độ và giá trên mỗi quyết định hẹp. System 2 tối ưu cho chất lượng suy luận trên tác vụ nhiều bước. Bảng dưới đây lấy đơn giá từ trang giá công bố chính thức của nhà cung cấp, đối chiếu ngày 10/10/2026. Giá có thể thay đổi, hãy kiểm tra lại trước khi tính ngân sách.
| Tầng | Model ví dụ | Đầu vào (USD/triệu token) | Đầu ra (USD/triệu token) | Việc điển hình |
|---|---|---|---|---|
| System 1 | Claude Haiku 5.5 (prompt tới 100.000 token) | 0,10 | 0,50 | Phân loại, định tuyến, trích xuất |
| System 1 | Gemini 2.5 Flash-Lite | 0,10 | 0,40 | Phân loại, định tuyến, trích xuất |
| System 1 | DeepSeek-V4.1-Flash (cache miss, giờ thấp điểm) | 0,15 | 0,60 | Phân loại, tóm tắt ngắn |
| System 2 | Claude Sonnet 5.5 | 2 | 10 | Lập kế hoạch, viết dài, tổng hợp |
| System 2 | Claude Opus 5.5 | 4 | 20 | Suy luận nhiều bước, ngữ cảnh phức tạp |
| System 2 | Gemini 3.1 Pro Preview (prompt tới 200.000 token) | 2 | 12 | Suy luận, phân tích dài |
Về độ trễ, các nhà cung cấp trên không cam kết một con số cố định trong trang giá. Vì vậy cột độ trễ không có trong bảng. Hãy đo độ trễ đầu cuối p50 và p95 trên chính khối lượng công việc của bạn.
Nguồn đơn giá: Anthropic, Google Gemini API, DeepSeek API. DeepSeek áp dụng giá giờ cao điểm gấp đôi giờ thấp điểm, và các tên model cũ đã được thay bằng tên mới trên trang giá.
Một router System 1 hoạt động ra sao?
Router nhận yêu cầu, trả về nhãn kèm mức tự tin, và chỉ chuyển lên System 2 khi nhãn thuộc nhóm phức tạp hoặc mức tự tin thấp. Khi không chắc, mặc định phải là chuyển lên, không phải tự xử lý.
Đoạn mã dưới đây là bản phác thảo để minh hoạ logic, không phải mã đang chạy trong một hệ thống cụ thể:
type Route = "simple" | "complex" | "unsafe";

async function route(input: string) {
  const { label, confidence } = await system1.classify(input); // model nhỏ

  if (label === "unsafe") return reject(input);       // gác cổng
  if (label === "simple" && confidence >= 0.8) {
    return system1.handle(input);                      // xử lý bằng phản xạ
  }
  return system2.handle(input);                        // leo thang khi phức tạp hoặc không chắc
}
Ngưỡng 0,8 trong ví dụ là giá trị minh hoạ. Ngưỡng thật phải được hiệu chỉnh trên một bộ yêu cầu có nhãn của chính bạn. Các quy tắc chắc chắn như kiểm tra quyền truy cập hay giới hạn dung lượng nên nằm trong code thường, không cần gọi model nào.
Chi phí thay đổi thế nào khi có System 1?
Trong kịch bản giả định dưới đây, kiến trúc phân luồng giảm khoảng 75–80% chi phí token so với chạy toàn bộ qua Claude Sonnet 5.5. Đây là kết quả tính toán từ các giả định ghi rõ, không phải số đo từ traffic thật.
Giả định của kịch bản:
- Một tháng có 10.000 yêu cầu. Mỗi yêu cầu gồm 1.000 token đầu vào và 300 token đầu ra.
- Phương án đối chứng: 100% yêu cầu đi qua Claude Sonnet 5.5 (2 USD đầu vào, 10 USD đầu ra mỗi triệu token).
- Phương án phân luồng: mọi yêu cầu đi qua Claude Haiku 5.5 trước. Tỷ lệ yêu cầu System 1 tự xử lý là 80% hoặc 85%. Phần còn lại được chuyển sang Claude Sonnet 5.5. Với yêu cầu bị chuyển, System 1 chỉ sinh khoảng 50 token đầu ra cho nhãn.
- Chưa tính phí lưu trữ cache, chi phí thử lại, chi phí giám sát và công thiết kế.
| Phương án | Tổng chi phí token/tháng (USD) | So với toàn bộ qua Sonnet 5.5 |
|---|---|---|
| 100% qua Claude Sonnet 5.5 | 50,00 | Mốc so sánh |
| System 1 tự xử lý 80%, 20% lên Sonnet 5.5 | 12,25 | Giảm khoảng 75,5% |
| System 1 tự xử lý 85%, 15% lên Sonnet 5.5 | 9,81 | Giảm khoảng 80,4% |
Cách đọc kết quả cho đúng: tỷ lệ 80–85% là một giả định, và chất lượng của System 1 trên tác vụ thật mới quyết định giả định đó có đứng được hay không. Nếu System 1 xử lý sai một phần yêu cầu, chi phí sửa lỗi và thiệt hại nghiệp vụ có thể lớn hơn phần tiền tiết kiệm. Đây chính là điều bài chi phí AI model rẻ chưa chắc vận hành rẻ lưu ý: đơn giá token chưa phải chi phí cho mỗi tác vụ được chấp nhận.
Khi có số đo thật, bảng cần bổ sung các cột độ trễ đầu cuối p50 và p95, tỷ lệ fallback, tỷ lệ phân loại sai và chi phí trên tác vụ được chấp nhận.
System 1 có những rủi ro nào và kiểm soát ra sao?
Rủi ro chính là phân loại sai và để lọt yêu cầu phức tạp vào luồng rẻ. Giảm rủi ro bằng cách chạy song song ở chế độ quan sát trước, ghi lại mọi lần leo thang, và đặt cổng duyệt tại bước có hậu quả.
- Chạy shadow mode trước: để System 1 phân loại song song nhưng chưa có quyền hành động, rồi so nhãn của nó với kết quả đúng đã biết.
- Mặc định leo thang khi không chắc: mức tự tin thấp thì chuyển lên System 2.
- Ghi nhận fallback: mỗi lần leo thang đều được ghi lại để đo tỷ lệ và phát hiện khi System 1 bắt đầu kém đi.
- Giữ cổng người duyệt: những bước có hậu quả khó đảo ngược vẫn cần con người, dù System 1 tự tin đến đâu. Xem bài Zero Trust cho AI Agent.
Lớp System 1 là một thành phần nằm trong kiến trúc rộng hơn mô tả ở bài AI Business OS là gì, nơi nó đóng vai trò gác cổng trước các agent chuyên trách.
Khi nào không nên dùng System 1?
Khi khối lượng yêu cầu quá nhỏ, khi yêu cầu nào cũng phức tạp, hoặc khi chưa có bộ dữ liệu có nhãn để kiểm tra. Thêm một tầng chỉ có lợi nếu phần lớn yêu cầu thật sự đơn giản và lặp lại.
Với vài trăm yêu cầu mỗi tháng, chênh lệch tiền token thường nhỏ hơn công sức dựng và kiểm tra router. Khi mỗi yêu cầu đều cần ngữ cảnh dài và suy luận nhiều bước, System 1 chỉ làm tăng độ trễ và điểm lỗi. Nếu chưa có dữ liệu có nhãn, bạn không có cách nào kiểm tra System 1 đúng hay sai, và việc dựng tầng này là đoán mò.
Câu hỏi thường gặp (FAQ)
System 1 trong AI Agent có thay thế hoàn toàn System 2 không?
Không. System 1 xử lý các quyết định ngắn, phạm vi hẹp với chi phí thấp. Những tác vụ cần lập kế hoạch nhiều bước hoặc tổng hợp ngữ cảnh dài vẫn cần System 2. Hai tầng bổ sung cho nhau và router quyết định việc nào đi đường nào.
Nên dùng model nào làm System 1?
Không có đáp án chung. Nên thử một vài model nhỏ, như Claude Haiku, Gemini Flash-Lite hoặc DeepSeek Flash, trên cùng một bộ yêu cầu có nhãn của bạn, rồi chọn theo độ chính xác phân loại, độ trễ đầu cuối và chi phí trên tác vụ được chấp nhận. Bảng giá chỉ là một đầu vào của quyết định.
System 1 có thực sự giảm được 80% chi phí không?
Con số 75–80% trong bài là kết quả của một kịch bản tính toán với giả định rằng System 1 tự xử lý được 80–85% yêu cầu. Mức giảm thực tế phụ thuộc vào tỷ lệ này, vào chất lượng phân loại và vào khối lượng công việc của bạn. Chỉ số liệu đo trên traffic thật mới xác nhận được.
Có cần kiểm thử System 1 trước khi cho nó hành động không?
Có. Nên chạy ở chế độ quan sát (shadow mode), để System 1 phân loại song song và so với kết quả đúng đã biết, trước khi cấp quyền hành động. Cần ghi lại mọi lần leo thang để đo tỷ lệ fallback.
Kết luận
System 1 là cách áp dụng một ý tưởng đơn giản: đừng dùng công cụ đắt cho việc rẻ. Giá trị của nó nằm ở việc trả lời được câu hỏi quyết định nào đủ đơn giản để xử lý bằng phản xạ, kèm cơ chế leo thang khi không chắc. Bài này dùng giá niêm yết và một kịch bản giả định để cho thấy quy mô chênh lệch có thể xảy ra, chưa kèm số đo từ một hệ thống thật. Tôi sẽ chỉ công bố số liệu hiệu quả khi có bộ đo đủ sạch để đứng được.
Nhận Bộ Thư Viện Prompt & SOP AI Workflow Vận Hành Doanh Nghiệp 2026
Tặng miễn phí Ebook PDF + Notion Template quản lý AI System thực chiến từ Tôi Là Tùng. Gửi trực tiếp vào hòm thư công việc của bạn.
Tặng File Cấu Hình AI Stack Tự Host (n8n + Flowise + pgvector)
Docker-compose sẵn dùng để tự dựng hạ tầng AI của riêng bạn trong vài phút — không cần trả phí SaaS hàng tháng.

Bài Liên Quan
Dual-Engine AI Agent: Bài học từ System 1 và System 2
AI Business OS là gì? Tầng vận hành AI cho doanh nghiệp